ブルームバーグの新しいロードマップレポートによると、Apple Siliconのメモリの上限は128GB、512GB、さらには1テラバイトのマークを超えようとしているという。このレポートは、AppleがAIを優先するためにチップサイクルを抜本的に見直しており、前例のない動きとして、このテクノロジー巨人が次期M6世代のPro、Max、Ultraの各バージョンを完全にスキップして、直接M7ファミリーに移行すると報じられている。
報告書によると、AppleはM6で同様の作業を行ってからわずか6か月後にM7のテープアウトプロセスを開始したという。この加速されたスケジュールの下では、ベースとなる M7 は早ければ来年前半に発売され、年末には Pro と Max が続き、最終的に 2028 年に M7 Ultra で最高潮に達する予定です。そのスタックの最上位にある M7 Ultra は、1.5 テラバイトという驚異的なユニファイド メモリをサポートするように設計されています。これは、次期 M5 Ultra で計画されていると伝えられている容量の約 2 倍ですが、RAM ポカリプスを考慮すると実際に何が利用可能になるかは誰にもわかりません。
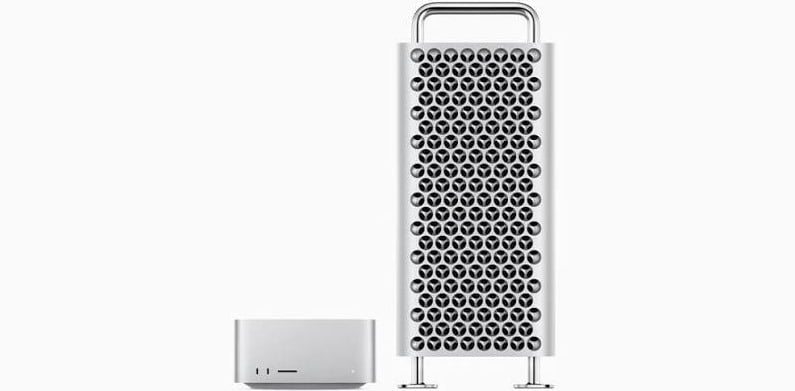
Appleはおそらくこのアーキテクチャに非常に傾倒しているため、エンジニアはすでに2029年の発売に向けてM7 Ultraをベースにした新しいAIサーバーチップを開発しており、これは計画されているコードネームJ246のM5 Ultraサーバーに続くものとなる。このレポートはまた、Apple が Cardinal という名前で他のハイエンド Mac チップと並んで 1.4 ナノメートルの M8 チップ (コード名 Soko) を準備していると主張しています。
1.5 TB のメモリ プールがデスクトップ Mac にとってばかげているように聞こえるのは、これが従来のコンピューティングに関するものではないからです。ブルームバーグは、M7 UltraはApple SiliconのAI性能を大幅にアップグレードし、NvidiaのBlackwellのような専用AIアクセラレータのクラスに近づけると報じている。大規模なフロンティアレベルの大規模言語モデル (LLM) を実行するには、モデルの重みをロードするためだけに膨大な量の VRAM が必要です。
Apple Silicon は、予算に優しい Mac Mini が OpenClaw などのツールを実行するためのデフォルトの常時接続サーバーになったため、草の根 AI コミュニティの最愛の人になりました。 Mac Mini には、OpenClaw にとって特別に「優れた」ハードウェアの魔法はありません。それは主に、作成者が最初にエージェント フレームワークを構築したプラットフォームであるため、非常に単純なインストール スクリプトが作成されたというだけです。これは、この種のものとして存在し得る手頃な価格のターンキー ソリューションにほぼ近いものです。
さて、 ブルームバーグの報道によると、その前提は、レベル5の自動運転を目指したAppleの100億ドル規模の自動運転車プロジェクトの中止により、カスタムシリコンと機械学習のブレークスルーの創出が必要になったというものだ。報告書は、この取り組みが「オンデバイスAI処理を担当するAppleチップの専用部分であるニューラルエンジンを生み出した」と主張し、この特定のテクノロジーが「MacをローカルでAIを実行するための最強のプラットフォームの1つに変えるのに役立った」と主張している。それは素晴らしい救いの物語になりますが、完全に的外れでもあります。
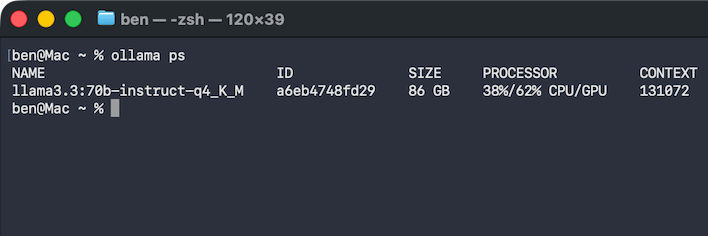
実際に Mac 上でローカル AI を実行することは、通常、Apple の Neural Engine とは事実上何の関係もありません。これは自分自身で見ることができます。 Ollama、LM Studio、または Apple 独自の MLX フレームワークなどのローカル エンジンを使用して LLM を起動すると、Neural Engine が完全に 0% に留まる一方で、Mac の GPU が 100% まで上昇するのを観察することができます。 AI の計算を行うのはニューラル エンジンではなく、M シリーズ チップの GPU です。
Apple の Neural Engine が役に立たないというわけではありませんが、機能がほとんど固定されたアクセラレータです。これは、FaceID のような低電力のバックグラウンド タスク、ウェブカメラの背景のぼかし、または基本的なオンデバイス書き込みツールの強化には最適ですが、重い LLM やローカル コーディング エージェントの実行に必要な動的な自己回帰計算には根本的に間違った形状です。
Apple が AI 開発者にうまくアピールできていないのは、キャンセルされた自動車プロジェクトによって同社にバックグラウンド NPU が与えられたためである。 Apple が AI 開発者に求愛しているのは、世界で最も効率的で大容量の VRAM プールを誤って構築したためです。 M7 Ultra が実際に 1.5 TB のメモリを搭載して出荷される場合、Apple は単に開発者に求愛するだけではありません。 NVIDIA や AMD の開発プラットフォームを飛び越えることになります。もちろん、2028 年はまだ先の話です。赤、緑、青のチームが今からそれまでにどんな驚異を明らかにするかは誰にもわかりません。