L'un des éléments qui font d'un test de performance un bon « référence » est la répétabilité, à la fois en termes d'« obtention de résultats similaires à chaque fois » et également de facilité de répétition du test de référence. Par exemple, certains jeux ne sont tout simplement pas adaptés pour être utilisés comme benchmarks, soit parce qu'ils ne sont pas cohérents, soit parce que cela prend trop de temps ou est trop fastidieux de les tester.
Le directeur de la gestion des produits de MLCommons n'est autre que Scott Wasson, connu pour son travail avec les divisions graphiques d'Intel et d'AMD, mais plus célèbre pour avoir fondé Le rapport techniqueaprès quoi il a été le pionnier de l'analyse comparative « Inside the Second », une méthode qui constitue encore aujourd'hui la base des tests de jeux sur PC. En tant que tel, Scott connaît son métier lorsqu’il s’agit de ce qui constitue une bonne référence.

MLCommons dispose déjà de dizaines de milliers de résultats de référence en matière de performances pour le matériel d'IA, mais l'organisation à but non lucratif a jusqu'à présent été largement impliquée dans l'industrie et le monde universitaire. Cependant, aujourd'hui marque la sortie de MLPerf Client 0.5, qui est la première version de MLCommons de son premier benchmark public. À l'heure actuelle, le client MLPerf est quelque peu limité, dans la mesure où il ne prend en charge que les plates-formes Windows 64 bits, il s'agit uniquement d'une ligne de commande et il comprend quatre tests basés sur un seul modèle.

À l'heure actuelle, MLPerf Client 0.5 dispose également d'une sélection assez limitée de matériel sur lequel il fonctionnera réellement. Le groupe a validé la référence pour les pièces AMD Radeon RX 7900, les SoC AMD Ryzen AI, les GPU discrets Intel Arc, les processeurs Intel Core Ultra Series 2 et les GPU GeForce RTX série 4000. Il prend en charge DirectML via ONNX Runtime pour tout, mais le matériel Intel bénéficie également d'un chemin OpenVINO spécialisé. Les participants sont également en mesure d'optimiser les modèles pour leur matériel, mais doivent respecter des directives strictes en matière de précision.
 Cliquez pour agrandir
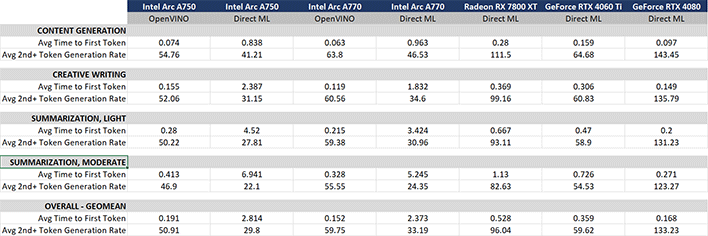
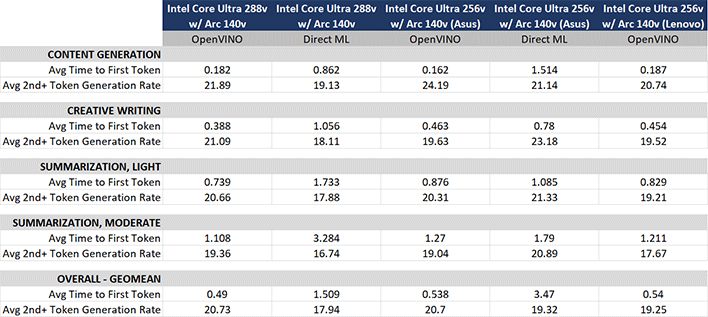
En effet, nous avons exécuté la version MLPerf Client 0.5 sur une gamme de matériels dont nous disposions et avons quelques résultats à partager. De manière unique, MLCommons ne fournit pas de résultats de référence officiels comme il le fait avec ses autres benchmarks. Au lieu de cela, le benchmark MLPerf Client 0.5 est gratuit et open source ; n'importe qui peut accéder à Github pour le télécharger et l'essayer.
Cliquez pour agrandir
Les Radeon RX 7800 XT et GeForce RTX 4060 Ti ne sont techniquement pas des configurations prises en charge ; MLCommons ne spécifie pour le moment que les GPU discrets de la série Radeon RX 7900, bien que le benchmark se soit bien terminé et ait en fait donné d'excellents résultats, du moins pour le débit. Pendant ce temps, les auteurs du benchmark préviennent que les GPU GeForce RTX série 4000 devraient avoir au moins 12 Go de mémoire intégrée, mais notre carte GeForce RTX 4060 Ti de 8 Go a également complété le benchmark sans problème.
Si vous souhaitez essayer MLPerf par vous-même, vous devriez pouvoir cliquer sur le MLCommonsGithub et téléchargez-le aujourd'hui. Extrayez simplement l'application dans un répertoire et ouvrez-y une fenêtre de terminal, puis exécutez « mlperf-windows.exe -c » où est le nom du fichier JSON correspondant à votre fournisseur de matériel. Si tout se passe bien, le benchmark téléchargera 7 à 10 Go de données avant le test, après quoi il affichera des chiffres que vous pourrez comparer avec nos données ci-dessus.