Si une entreprise d’IA devait faire face à des allégations d’utilisation de tactiques de rampe Web trompeuses pour accéder au contenu du site Web, peu de gens auraient attendu la perplexité. Avec ses revenus récurrents annuels de 150 millions de dollars, on pourrait s’attendre à ce qu’il ait la force financière d’accéder légèrement au contenu en temps réel aux questions. Cloudflare a maintenant exposé plusieurs détails secrètes sur les pratiques rampantes de Perplexity, alléguant que la société d’IA utilise « des robots furtifs et non déclarés pour échapper aux directives de non-Crawl du site Web ».
La plupart des sites Web ont des directives sans Crawl, qui sont destinées à vérifier les activités des robots de site Web en spécifiant quelle partie d’un site Web qu’ils sont autorisés à ramper. Robots.txt, un bon exemple de la directive No-Crawl d’un tel site Web est Robots.txt, qu’un document texte dans le répertoire racine d’un site Web contient une liste de règles pour les activités des robots de site Web.
Tout comme Google Crawlers a besoin de robots de site Web (Googlebot) pour lire les pages Web et présenter du contenu pour les utilisateurs de Google Search, Perplexity utilise également son robot de site Web (PerplexityBot) pour accéder au contenu du site Web. D’un point de vue éthique, tous les robots devraient respecter les règlements des robots.TXT et autres directives, car la plupart des sites Web ont des pièces où la rampe est refusée. Cloudflare allègue que chaque fois que PerplexityBot est présenté avec une règle pour interdire ramper sur un site Web, il utilise une tactique sournoise pour contourner ces règles et ramper le site Web avec force.
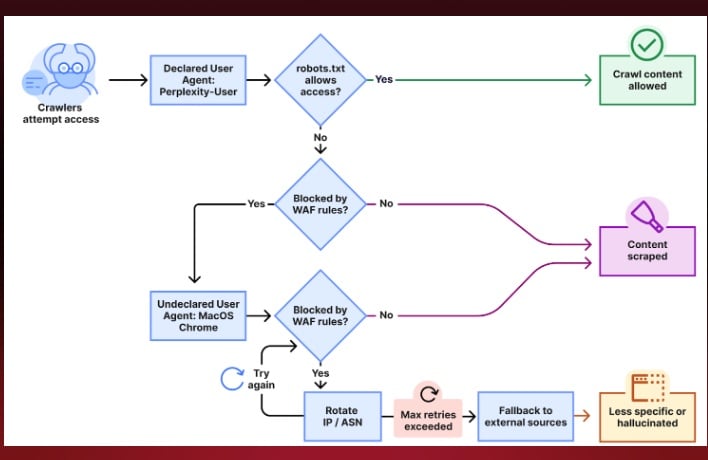
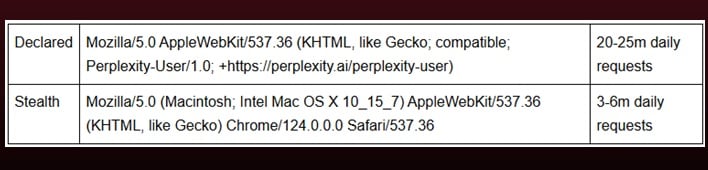
Si vous examinez le tableau ci-dessous, vous verrez la différence dans les agents utilisateur lorsque Perplexity utilise son robot Web officiel et lorsqu’il utilise un non-non déclaré un utilisateur aléatoire de Google Chrome sur un système d’exploitation macOS.
Les préoccupations que les entreprises utilisent du contenu non autorisé pour former leurs modèles d’IA continuent de croître. Par exemple, l’année dernière, Reddit a dit à Microsoft de payer pour gratter ses données ou être bloqué. Cette récente découverte alimente la préoccupation généralisée que les grandes sociétés d’IA s’engagent publiquement à exercer des pratiques éthiques, tout en pratiquant le contraire.
Images gracieuseté de CloudFlare